C语言学习笔记——函数
C语言学习笔记——函数
Kanwuqing流程控制那篇的猜数字程序里, 判断"大了小了"那段逻辑写了三遍. 输错要重来, 三次机会就是三段几乎一样的代码. 更早的第一个程序里其实已经见过函数了, main 就是一个, 只是当时没解释它凭什么叫"函数"
那篇里说过 一个 C 函数由首部 + 函数体两部分组成, 这个说法一直挂着没展开. 这篇就把它落实, 顺便解决"同样的代码写好几遍"这个问题
1 为什么需要函数
猜数字里判断大小的逻辑长这样:
1 | if (guess == answer) { |
逻辑本身不难, 但它只在"用户输入了一个数之后"才有意义. 如果程序多了个功能, 比如让用户按回车再猜一次, 或者记录每一轮的判断结果, 这段判断就得再抄一遍
抄一遍的代价不只是多打字. 更要紧的是改的时候容易漏改: 哪天想把提示语从"大了"改成"猜大了", 有五个地方要改, 漏掉一个就出现前后不一致的行为
函数解决的就是这个. 把这段逻辑起个名字包起来, 以后要用的地方写个名字就行:
1 | void judge(int guess, int answer) { |
之后调用的地方只需要写 judge(50, 42); 一句话. 改提示语时也只改这一个地方
顺着说一句: C 语言里函数不能嵌套定义, 也就是不能在一个函数体里再写一个完整的
function. 所有函数都是平级的, 想复用只能调用, 不能"内嵌"
2 函数的形状
第一个程序里提过的那句话, 现在可以具体化了. 任何函数都是这个形状:
1 | 返回值类型 函数名(参数列表) <- 首部 |
拿一个具体的看:
1 | int add(int a, int b) { // 首部 |
首部里每一段都有名字, 考点也常在这里:
| 位置 | 名字 | 上面例子里是 |
|---|---|---|
| 最前面 | 返回值类型 | int |
| 中间 | 函数名 | add |
| 括号里 | 参数列表(形参) | int a, int b |
返回值类型决定这个函数"算完之后给出什么东西". int add(...) 说明它给出一个整数. 如果函数只是干活、不需要交回结果, 就写 void:
1 | void show(int n) { |
void 的意思是"什么都不返回". 这种函数里不能写 return 值;, 只能写 return;(或者干脆不写)
参数列表是函数的入口. 上面 add 需要两个整数才能算, 就声明两个. 不需要任何输入的函数写成 (), 里面什么都不放
有个 C 语言的历史遗留问题: () 和 (void) 不是完全一样的意思
int f()意思是"参数列表未指定", 编译器不检查传了几个参数int f(void)明确表示"没有任何参数", 传了参数就报错
严格说 (void) 更严谨, 但实际写代码时 () 用得更普遍, 看着也清爽. 考试和日常都用 () 就行, 知道即可
3 调用、参数与返回值
定义好函数之后, 用它的方式是函数名 + 括号:
1 | int r = add(3, 4); // r 得到 7 |
这里面的名词要分清, 考试选择题常拿它们做文章:
1 | int add(int a, int b) { // a, b 是【形参】 |
- 形参(形式参数): 定义函数时写在首部里的
a、b, 是占位符 - 实参(实际参数): 调用时真正传进去的
x、y, 有具体的值
调用发生时, 实参的值会一对一地抄给形参. 顺序不能错:
1 | int sub(int a, int b) { return a - b; } |
return 干两件事: 把值交回去, 以及立刻结束这个函数. 所以下面这种写法, 后面的语句根本执行不到:
1 | int f(int n) { |
一个函数只能返回一个值. 想返回多个, C 里没有现成语法(得靠指针改传进来的变量, 或者返回结构体), 这是新手常踩的预期偏差
4 函数声明
函数定义的位置有讲究. 看这段:
1 |
|
main 里用到 add 的时候, 编译器还没见过 add 是什么. 在 C89 里这会给出警告(甚至默认当整型处理), 正确做法是先声明:
1 |
|
声明和定义的区别要记牢:
- 声明(也叫函数原型)只介绍"有这么个函数, 长什么样", 不写函数体, 末尾是分号
- 定义是完整实现, 带函数体
一个函数可以声明很多次, 但只能定义一次
实际写代码时, 只要把函数定义写在
main之前, 就不用单独声明了, 因为编译器从上往下读, 到main时已经见过定义. 这是最省事的做法, 本书后面都这么写顺带一说,
#include <stdio.h>引进来的stdio.h里全是函数声明. 之所以能直接用printf, 就是因为头文件替我们打好了招呼
5 参数传递是"值传递"
这一节是整篇最重要的, 也是指针那篇要接着解决的问题
C 语言的参数传递只有一种方式: 值传递. 意思很简单, 实参的值被复制一份给形参, 函数里怎么改, 都只改那个副本
1 | int add(int a, int b) { |
函数里把 a 改成 100, x 一点没变. 因为 a 只是 x 的一份拷贝, 改了拷贝动不了原件
这个性质最经典的后果是:写不出一个真正交换两个变量的 swap. 下面这个写法是错的:
1 | void swap_wrong(int a, int b) { |
实测输出 x=1 y=2. 函数内部 a 和 b 确实换了, 但换的是两个副本, x y 毫发无损
语言这么设计是出于安全的考虑. 函数拿到的是一份拷贝, 就不可能悄悄改掉外面的变量. 要真正交换, 必须告诉函数"变量在哪儿", 也就是传地址. 这就是指针篇的内容:
1 | void swap(int *a, int *b) { /* 收的是地址 */ |
这个方向先记着, 等看完指针篇再回头看这一节, 会特别清楚
"值传递"这个规则只有一个例外: 数组
数组作参数时, 传过去的是数组的地址, 不是整个数组的拷贝. 所以函数里改数组, 会影响外面的原数组
这不是规则被破坏了, 而是"数组名本身就代表地址", 传的仍然是"值", 只不过那个值恰好是个地址. 第 10 节会详细说
6 局部变量与全局变量
变量的"地盘"分两种:
局部变量定义在函数内部, 只有这个函数能用:
1 | void f() { |
全局变量定义在所有函数外面, 所有函数都能用:
1 | int count = 0; /* 全局变量, 下面两个函数都能访问 */ |
两者有一个关键差别, 在数据类型里提过: 局部变量不初始化是垃圾值, 全局变量不初始化自动是 0
1 | int g; /* 全局, 自动 = 0 */ |
全局变量看着方便, 但能不用就别用. 因为它对所有函数可见, 谁都能改, 出了问题很难查是哪个函数改的. 更实际的问题是: 全局变量会一直占着内存, 直到程序结束
局部变量和全局变量重名时, 局部的优先
1 | int x = 100; /* 全局 */ |
这叫就近原则. 函数内部看得到自己的 x, 就不会去外面找. 全局那个 x 还在, 只是被挡住了
7 作用域与生存期
上面说的"谁能用"和"活多久"其实是两件事, 各有专门的词:
- 作用域: 一个变量在代码的哪些地方能被访问到
- 生存期: 一个变量在运行时什么时候存在
大部分情况下两者是一致的, 但也有分开的时候(第 8 节的 static 就是)
作用域的规则很简单, 看大括号:
1 | int main() { |
变量从定义它的那一行开始生效, 到它所在的 } 结束. 出了这个范围就不存在了
变量必须先定义后使用. 这一条看起来废话, 但有个容易忽略的细节:
1 | int main() { |
在 C 里, 变量只在定义之后的代码里可见. 上面的 printf 在定义之前, 所以编译器不认识 a
另外, C89 要求所有变量声明放在语句块的开头. 也就是这样才对:
1 | int main() { |
C99 才允许"用的时候再声明". 考试环境(VC++ 2010)按 C89, 必须把声明写在块开头
8 存储类别
这四个关键字管的是"变量存在哪儿、活多久". 前两个最常用, 后两个见过即可
auto 是默认值, 可以省略. 现在写的所有局部变量其实都是 auto:
1 | int x; /* 等价于 auto int x; */ |
日常几乎不写 auto, 知道有这回事就行
static 最有意思. 用 static 修饰局部变量时, 它的生存期会从"函数结束"延长到"程序结束", 但作用域不变(还是只有那个函数能用):
1 | void counter() { |
实测输出:
1 | count=1 |
关键在这: c 只被初始化一次, 之后每次调用都保留上次的值. 如果去掉 static(就是普通的 int c = 0;), 三次都会输出 count=1, 因为每次调用都是全新的 c
static 修饰全局变量或函数时, 意思是"只在这个文件里可见", 别的文件用不了. 这个用途要到多文件的项目里才体现, 现在了解即可
register 建议编译器把变量放在寄存器里, 求个快:
1 | register int i; |
这是个建议, 编译器可以不听. 而且现代编译器自己会做优化, 这个关键字基本没用了. 考试里偶尔考"它不能取地址", &i 是错的, 因为寄存器没有地址
extern 声明"这个变量/函数在别的文件里定义过, 我这里只是引用":
1 | extern int g; /* 声明: g 在别的文件里定义了 */ |
单文件程序里用不到, 多文件才需要
9 递归
函数自己调用自己叫递归. 最经典的例子是阶乘: $5! = 5 \times 4!$, 而 $4! = 4 \times 3!$, 一路推下去
1 | int fact(int n) { |
fact(5) 的计算过程是一层层展开, 再一层层收回:
1 | fact(5) = 5 * fact(4) |
递归必须有终止条件, 否则栈溢出
1 | int f(int n) { |
这个函数每次调用都要先算 f(n+1), 而 f(n+1) 又要先算 f(n+2)……一路递归下去, 每次调用都要在栈上占一块地方, 最后把栈用光, 程序崩溃
写递归时必须想清楚两件事:
- 什么时候停(终止条件)
- 每次有没有往终止条件靠近(上面的
n - 1就是在靠近)
少一样都会出问题
递归能做的事, 用循环也能做. 上面那个阶乘改成循环:
1 | int fact_loop(int n) { |
实际开发中循环通常更快也更省内存(递归每次调用都要压栈). 递归的价值在于某些问题用它写出来特别简洁, 比如后面结构体篇的链表操作、树遍历. 考试里递归一般只考"写出结果"和"终止条件"这两件事
10 数组作函数参数
这一节是为数组与字符串那篇铺路的, 因为数组最常干的事就是交给函数处理
数组可以传给函数, 形参有两种写法, 完全等价:
1 | void print(int arr[], int n) { ... } /* 写法一 */ |
因为数组作参数时传的是地址, 不是整个数组的拷贝. 这和上一节说的"值传递"不矛盾, 传的确实是个"值", 只不过那个值是个地址
这就带来两个非常实用的后果:
第一, 函数里改数组, 外面的原数组跟着变. 这个性质虽然不是"值传递"的字面意思, 但极其有用:
1 | void setzero(int arr[], int n) { |
如果数组是完整拷贝过去的, 这个函数就毫无意义了, 改完副本, 原数组还是原样. 正因为传的是地址, 它才能真的"清空"数组
第二, 函数里 sizeof 数组得不到正确结果:
1 | void f(int arr[]) { |
函数里的 arr 已经不是数组了, 而是一个指针. sizeof 一个指针, 得到的自然是指针的大小(8 字节或 4 字节), 不是数组的大小
所以必须额外传一个长度参数. 这就是为什么所有数组处理函数的首部都是 (int arr[], int n) 这个样子, 那个 n 不是多余的, 是必需的
sizeof(arr) 在函数里得到 8 还是 4, 和机器的指针宽度有关. 我这里测的是 64 位环境, 所以得 8
考试环境是 32 位, 指针 4 字节, 那里会输出 4. 具体数值不重要, 关键记住"函数里 sizeof 数组 ≠ 数组真实大小"
GCC 对这种写法会直接给警告:
1 | warning: 'sizeof' on array function parameter 'arr' will return size of 'int *' |
看到这句, 就说明该补长度参数了
11 一个例子, 把猜数字拆成函数
把流程控制那篇的猜数字改造一下. 原来所有逻辑都堆在 main 里, 现在拆成几个函数:
generate_answer()给出答案judge(guess, answer)判断大小, 返回结果代码play()跑完整一局
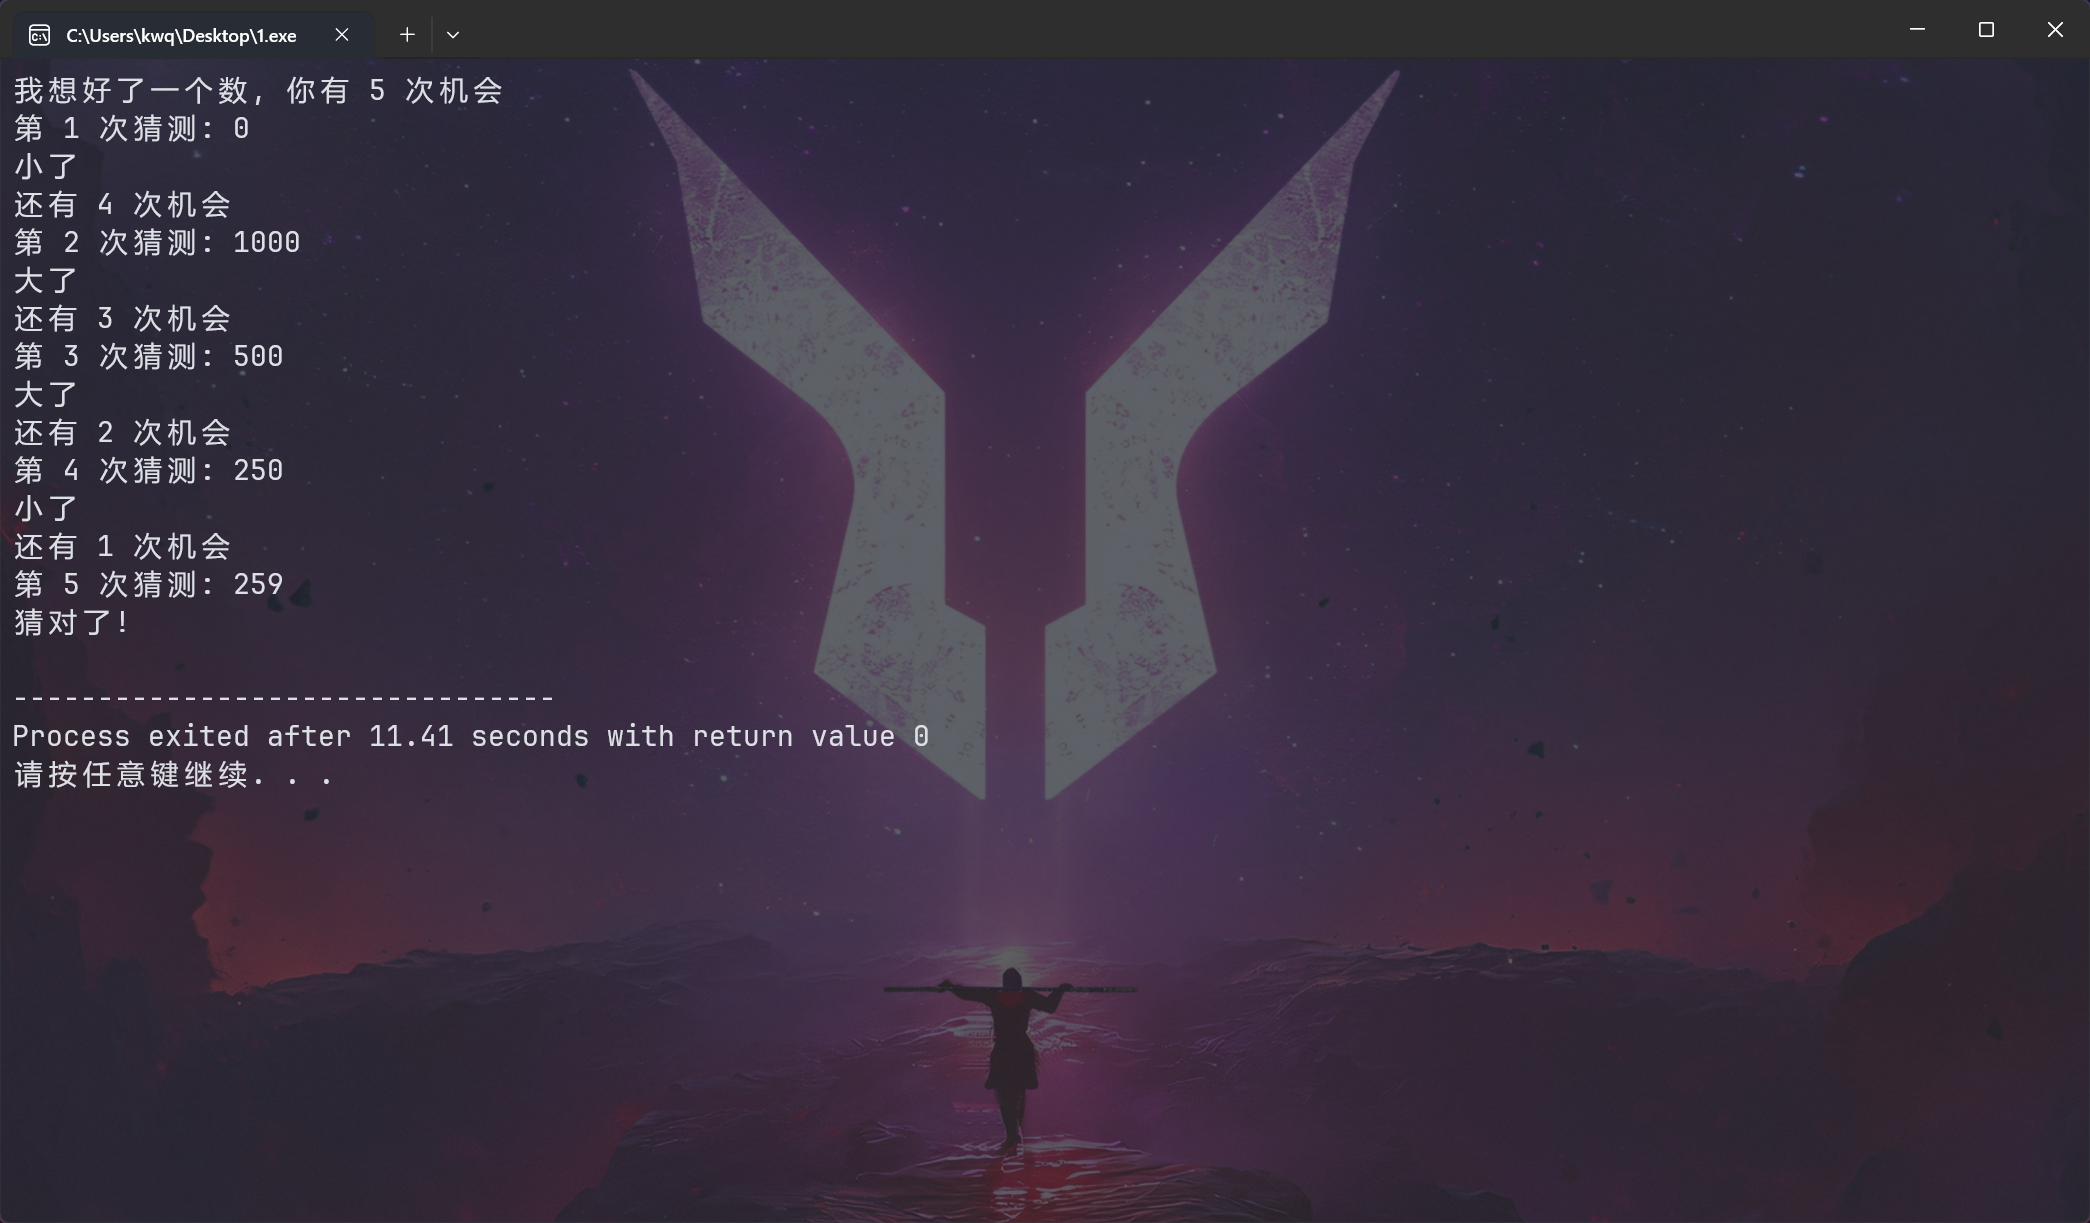
示例代码
1 |
|
拆完之后有几个明显的变化:
- 判断逻辑只出现一次, 就在
judge里. 原来如果要多处判断, 现在只要调judge就行 judge返回的是代码(1/0/-1)而不是直接打印, 这样调用方可以自己决定怎么用. 这种"把计算和显示分开"的写法很常见,judge只负责算,say只负责说play有返回值, 告诉调用方"赢没赢", 这样main里可以根据结果做别的处理
实测两次运行的输出:
1 | 我想好了一个数, 你有 5 次机会 |
1 | 我想好了一个数, 你有 5 次机会 |
这段代码里有个看起来像 bug 但其实不是的地方: judge 里用了三个 return, 中间那个 if (guess > answer) return 0; 后面没写 else
这不是省略, 是故意的. return 执行完函数立刻就结束了, 后面的代码不会再跑. 所以:
1 | if (guess == answer) return 1; /* 相等就直接返回了 */ |
这种写法叫提前返回(early return), 比写一大串 else 嵌套更清楚. 但要注意它依赖 return 的"立刻结束"特性, 换成 printf 之类的语句就不能这么省 else 了
12 *函数调用时的内存
前面反复说"值传递"“副本”, 这一节看看底层到底是什么样子, 这是理解递归和局部变量的关键
每次调用函数, 系统都会在栈上开辟一块专门的区域给这次调用用, 叫栈帧(stack frame). 里面放两样东西:
- 这次调用的局部变量
- 调用结束之后该回到哪里继续执行
拿 add(3, 4) 看:
1 | int add(int a, int b) { |
内存里大致是这样:
1 | main 的栈帧 |
main 里调用 add 的那一刻, 系统做了三件事:
- 把实参
3、4复制进add的栈帧(这就是"值传递"在机器层面的样子, 实实在在的内存拷贝) - 把"回来之后接着执行哪一行"记下来
- 跳到
add的代码开始跑
add 跑完 return s 时, 反过来: 把 s 的值送回去, 然后把 add 的整个栈帧销毁, 按记下的返回地址跳回 main
这就是"局部变量出了函数就消失"的真正原因, 不是被清零了, 是整块地方被回收了. 再调用别的函数时, 那块地方会被重新利用, 所以在外面看到的"残留值"其实是别人留下的
也解释了为什么递归会栈溢出: 每递归一层就要新建一个栈帧, 而且上一层的不销毁(因为它还没算完, 等着下层返回), 层层堆叠, 栈空间用光就崩
数据类型里说过"局部变量没赋值是垃圾值", 现在知道垃圾从哪来了. 就是上一次用这块栈帧的函数留下的东西. 换台机器、改下代码, 栈的布局变了, 那个"垃圾"也跟着变
顺带说清 “值传递” 这个词的由来: 传的确实是值本身, 通过内存拷贝实现. 这也是为什么改形参动不了实参, 它们从一开始就是两块不同的内存