C语言学习笔记——数据类型
C语言学习笔记——数据类型
Kanwuqing观前提醒: 本章干货极多, 书中以表格展现为主, 本人认为这样反人类反直觉, 且极难学习, 故在本篇笔记中穿插了大量具体实例辅助理解, 同时对于一些结论性的内容辅以具体推算, 不要一口气吃完, 读读写写才有效
第一个程序里我们用 int age; 存过一个年龄, 但没解释那个 int 是什么意思. 这篇就来说清楚"数据往哪儿放、能放什么"
0 综述
1 | 数据类型 |
1 为什么需要变量
第一个程序最后的那个例子是这样的:
1 | int age; |
程序要接住用户输入的东西, 等会儿再拿出来用. 那就需要一个地方先把数字存起来, 这个地方就是变量
最朴素的写法是直接写死:
1 | printf("%d", 18); |
这样当然也能输出 18, 但用户输入什么它都只会输出 18. 想输出用户真正输入的值, 就必须有个"盒子"先接住它——这就是变量存在的理由
2 变量的三个要素: 类型、名称、值
定义变量的时候, 我们写的是这样一行:
1 | int age = 18; |
注意 int 和 age 之间必须有空格(或者至少一个分隔), 写成 intage 会被当成一个完整的标识符. 这一行同时交代了三件事:
类型是 int, 它决定这个盒子能装什么、装多大. 名称是 age, 用来找到这个盒子. 值是 18, 盒子里实际装的东西.
打个比方: int age = 18; 就像在一个柜子上贴了标签"年龄"(名称), 规定这个格子只能放整数(类型), 然后往里放了一张写着 18 的纸条(值)
三要素的顺序是有讲究的: 先说类型, 因为类型决定了这个盒子怎么解释里面的 0 和 1. 同样一串二进制, 按
int解释和按float解释出来的数字完全不一样, 这一点在第 13 节会彻底讲清楚
值不是必须的.
int age;只声明了一个盒子, 里面是不确定的值这里要区分清楚: 在函数内部定义但没赋值的变量, 值是不确定的(是内存里残留的垃圾); 而在所有函数外面定义的全局变量, 初始值自动为 0. 很多人以为没赋值就是 0, 这在局部变量上是错的
3 命名规则与标识符
盒子上贴的标签不能乱起. C 语言规定, 标识符(也就是你起的各种名字)必须满足:
- 只能由字母、数字、下划线组成
- 第一个字符必须是字母或下划线, 不能是数字
- 不能是关键字(比如
int、if、return) - 区分大小写(
age和Age是两个不同的变量)
1 | int age; // 合法 |
第 4 条"区分大小写"要单独强调一下: age、Age、AGE 是三个互不相干的变量, 写错了编译器不会报错, 只会让你得不到想要的结果. 这种 bug 特别难查
另外要记住: 关键字不能用作变量名, 但
main不是关键字, 它是函数名, 理论上可以, 但如果当变量名属于自己找麻烦
4 基本数据类型
C 语言的数据类型看着挺多, 其实核心就四个. 先把这四个认清, 其余的以后再说
4.1 四个最基本的脸
整数用 int:
1 | int age = 18; |
小数分两种, float 和 double. float 是单精度, double 是双精度, 听着也知道double更厉害:
1 | float pi = 3.14f; // 注意float型后面加f |
单个字符用 char:
1 | char c = 'A'; |
为什么小数要分两个? 因为精度和空间是矛盾的. double 更精确但占地方更多. 平时写小数建议直接用 double, 省得因为精度不够算出奇怪的结果
写 float 的字面量时通常加个 f, 比如 3.14f. 不加的话 3.14 会被当成 double, 赋给 float 可能触发一个警告
单引号和双引号千万别混:
'A'是字符(占 1 字节),"A"是字符串(占 长度+1 个字节, 末尾还有个看不见的结束标志). 这个坑留到数组篇细说, 现在只要记住单引号包字符, 双引号包字符串
4.2 char 为什么能参与运算
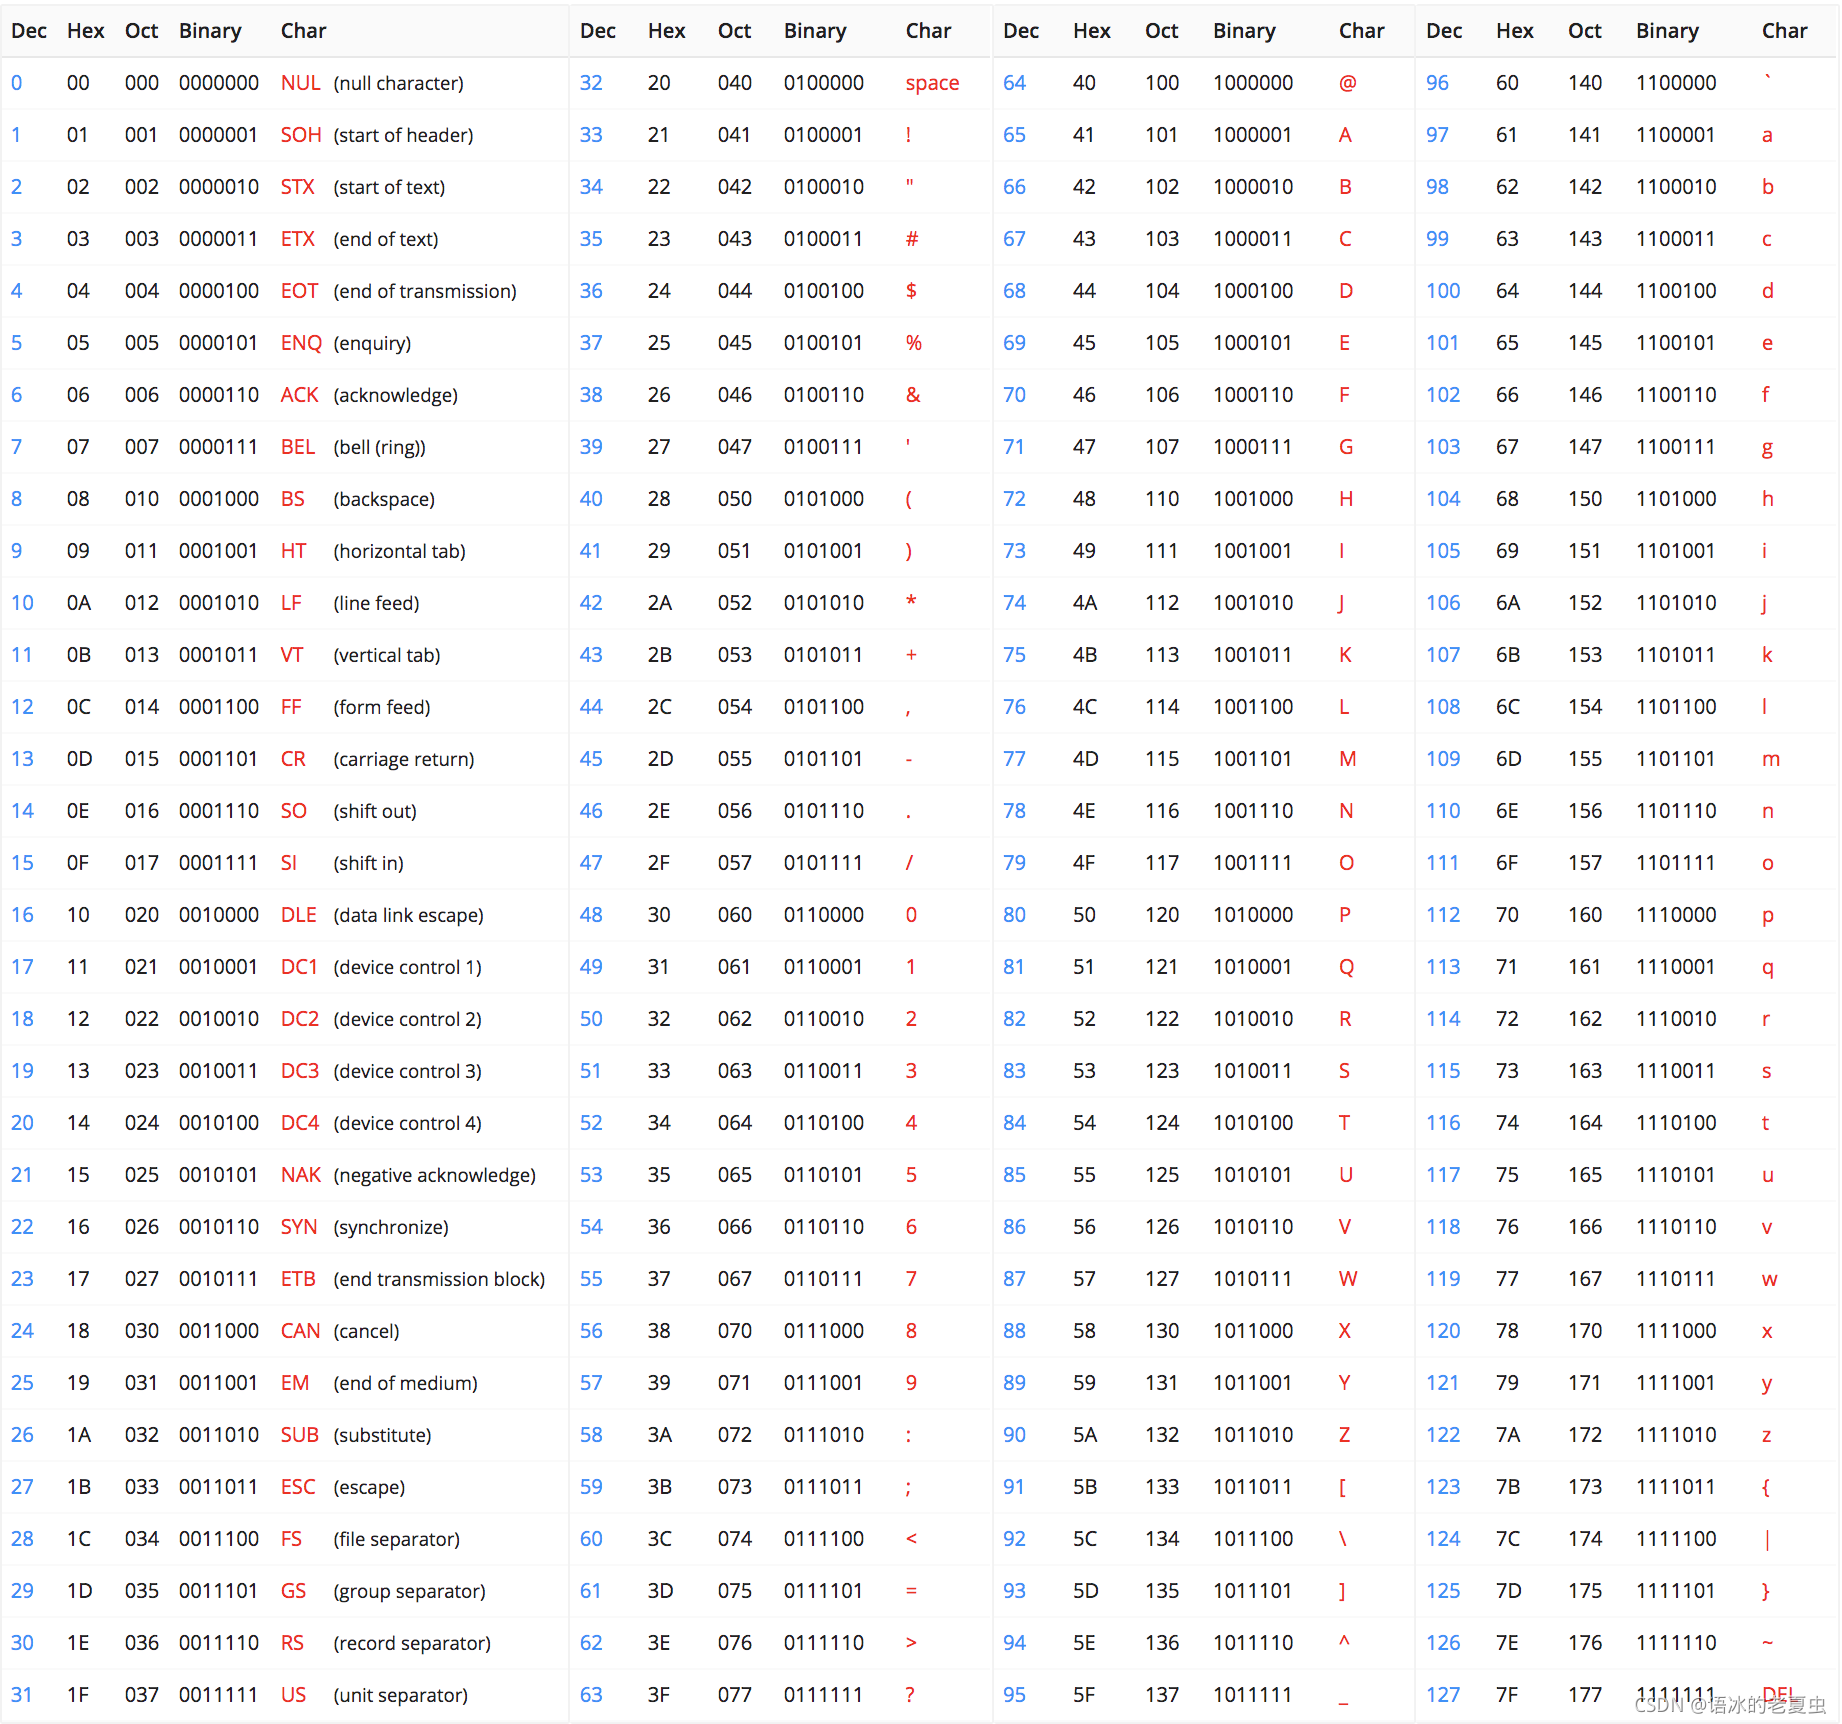
char 存的是字符, 但它本质是个小整数. 因为计算机里没有"字母"这种东西, 字符是靠一张对照表(ASCII 码)翻译成数字来存的. 'A' 实际上存的是 65.
写出来看看:
1 | printf("%c\n", 'A'); // 输出 A (按字符解释) |
同一个 'A', 用 %c 输出是字母 A, 用 %d 输出是数字 65. 存的都是同一串二进制, 只是解释方式不同.
这也解释了大小写字母怎么互相转换: 因为 'a' 比 'A' 正好大 32
1 | printf("%d\n", 'a' - 'A'); // 输出 32 |
注意数字字符
'0'是 48 而不是 0. 想把字符'5'变成数字 5, 要写'5' - '0', 这是个常用套路
4.3 为什么 ASCII 只有 128 个
ASCII 的英文全称是 American Standard Code for Information Interchange(美国信息交换标准代码). 它占用1个字节(8比特, 荒野乱斗玩家狂喜), 而由于包含校验位, 因此其最终只占用7比特来编码:
所以标准 ASCII 只有 0~127 共 128 个字符, 包括:
- 0~31 和 127: 控制字符(换行、回车、退格等, 看不见)
- 32: 空格
- 48~57: 数字
'0'~'9' - 65~90: 大写字母
'A'~'Z' - 97~122: 小写字母
'a'~'z'
那剩下的一半呢? char 明明有 8 位, 能用 256 个. 这个矛盾是历史造成的: 当年只需要编码英文, 7 位就够用了, 第 8 位常被拿去做校验位. 后来大家把第 8 位也用上了, 于是有了 128~255 的扩展 ASCII, 用来放各国自己的字符(比如西欧的重音字母)
但扩展部分各国不统一, 所以中文没法用 1 字节表示, 只能另起炉灶搞出 GB2312 这种双字节编码. 这就是"一个汉字占 2 字节"的来历
控制字符里要知道0代表的是
NUT(字符串终止符)
拓展: char类型有无符号测试(省流: 有, 范围-128~127)
还有个容易忽略的点:
char到底是有符号还是无符号, C 标准没有明确规定, 由编译器决定. 在 VC 环境下char是有符号的, 范围是 -128~127实测一下就很直观:
1 | char c = 128; |
5 类型修饰符
有了上面四个基本类型, 接下来才轮到"修饰符". 它们的作用是在基本类型上做微调.
先看变长的 long, 它让整数能装更大:
1 | int a = 100000; |
再看变短的 short, 用来省空间:
1 | short s = 100; |
short、long 其实都是 short int、long int 的简写, 那个 int 可以省掉:
1 | short int a; // 等价于 short a; |
然后是 unsigned, 这是最值得理解的一个:
1 | unsigned int c = 4000000000; // 能存下 40 亿 |
原理是: 一个 int 本来是 4 字节 32 位, 大概能表示正负 21 亿(2^31-1). 加上 unsigned 之后, 原本用来表示正负号的那一位也拿去存数值了, 于是范围变成 0 到约 42 亿 —— 能表示的最大值翻倍了, 但再也不能表示负数
这也解释了一个经典现象: 给 unsigned 变量赋一个负数, 它不会变成负的, 而是会绕到范围另一端变成一个巨大的正数:
1 | unsigned int u = -1; |
signed是默认的, 你不写就等于写了. 所以int和signed int等价修饰符的顺序一般不影响结果,
unsigned int和int unsigned等价. 但long long这种写法不在最早的 C89 标准里
*5.1 拓展: 各种类型的取值范围
既然修饰符是在调"能装多大的数", 那就该把每种类型具体能装到多少列清楚. 不过我们不用记那些一长串的数字, 而是记成 2 的幂——这样既好背, 也能顺便理解范围是怎么来的
先看有符号的:
| 类型 | 字节数 | 取值范围 |
|---|---|---|
char |
1 | |
short |
2 | |
int |
4 | |
long |
4 |
再看无符号的, 其实就是把负数部分搬到了正数另一侧:
| 类型 | 字节数 | 取值范围 |
|---|---|---|
unsigned char |
1 | |
unsigned short |
2 | |
unsigned int |
4 | |
unsigned long |
4 |
注意对于
long类型(包括unsigned long), 其在32位系统中占用4字节, 而在64系统中占用8字节, 从而范围中的31和32需变为63,64, 这也是其与int类型不同的地方
为什么是这个范围? 拿 int 举例, 它占 4 字节 = 32 位, 所以总共能组合出
如果是有符号的, 这
但上面那个说法其实本末倒置了, 事实上是先决定int范围再分配其占用的位数
注意负数能表示的范围比正数多一个. 原因就是 0 把正数那边的名额占掉了一个, 而 0 在补码里是唯一的(不存在"-0"), 所以负数白赚一个位置
如果是无符号的, 那这
这也正好解释了前面那个例子: unsigned int u = -1; 得到 4294967295. 因为 -1 在补码里是 32 位全 1, 而无符号解释下"全 1"就是最大值
记住这个规律就不需要背具体数字了: 范围大小看字节数, 有符号就对半分再往两边挪一格, 无符号就全给正数
再次强调
long在考试环境(32 位 VC)下是 4 字节, 和int一样, 所以范围也一样. 这也是为什么平时用int就够了——在这个环境下它俩没区别
常考的几组是
int是、 unsigned int是、 char是. 如果题目给具体数字, 记住 int的边界是 2147483647(约 21 亿)就够了
6 各类型占多少字节: sizeof
要搞清楚"这个类型到底占多大", 就用 sizeof:
1 | printf("%d\n", sizeof(int)); // 输出 4 |
常见类型的大小(32/64 位 Windows 环境下):
| 类型 | 字节数 |
|---|---|
char |
1 |
short |
2 |
int |
4 |
long |
4 |
long long |
8 |
float |
4 |
double |
8 |
sizeof是运算符, 不是函数! 这是本篇最值得记的一个考点判断依据很简单: 它是 C 语言的关键字(32 个关键字里就有它), 而且不需要
#include任何头文件就能用. 函数必须包含头文件才能调用,sizeof不用, 所以它是运算符它的写法也带点运算符的味道: 作用于变量时括号可以省,
sizeof a和sizeof(a)都对. 但如果作用在类型名上, 括号就不能省 ——sizeof int是语法错误, 必须写sizeof(int)
上面这张大小表在标准环境(32 位 VC)下是准确的. 但注意
long的大小会随平台变化——Linux 64 位下它是 8 字节. 考试按 4 字节记另外一个小坑: 严格来说
sizeof的结果类型是size_t(无符号整数), 不是int. 在 64 位环境下直接拿%d输出会收到警告. 考试里按%d写一般没问题, 知道原理即可
7 常量
变量是"能变的盒子", 常量就是不能变的值.
7.1 整型常量
最普通的是十进制:
1 | int a = 123; |
但 C 语言还允许写八进制和十六进制, 靠前缀区分:
1 | int b = 0123; // 前导 0 -> 八进制, 等于十进制 83 |
前导 0 这个坑在存储器与进制里详细讲过. 记住 0123 不是 123, 而是 83
还可以加后缀表示类型:
1 | 123L // long |
7.2 实型常量
实型(小数)有两种写法. 普通小数形式:
1 | double a = 3.14; |
指数形式:
1 | double b = 1.5e3; // 表示 1.5 x 10^3 = 1500 |
指数形式有个硬性规则, 考题常考:
1 | 1.5e3 合法 |
记住一句话: E 的前后都必须有数字, 且 E 后面必须是整数
7.3 字符型常量
1 | char c = 'A'; |
7.4 const
给变量加上 const 就变成"只读"的了:
1 | const int MAX = 100; |
那这时候就有人要有疑问了: 我要只读变量有啥用呢, 我不改它不就不用写const了吗?
实际上, const在此处是起到保护作用, 保证了只读就不会因为误改等原因出现一些莫名其妙的bug
8 转义字符
先看一段代码, 感受一下为什么需要转义字符:
1 | printf("第一行 |
这样写是错的 —— 字符串不能直接跨行. 想换行得用 \n:
1 | printf("第一行\n第二行"); |
\n 就是转义字符, 反斜杠加上一个字母, 合起来表示一个"看不见的字符".
8.1 最常用的两个: \n 和 \t
1 | printf("第一行\n第二行\n"); // \n 换行 |
\t 输出的是制表符(Tab), 相当于按了一下 Tab 键, 常用来对齐成表格的样子
8.2 怎么表示 " 和 \ 本身
1 | printf("他说: \"你好\""); // 输出: 他说: "你好" |
为什么需要转义? 因为 " 和 \ 在字符串里是"有特殊身份"的字符. 想表示"字符串内部的一个引号"或"一个普通的反斜杠", 就得在前面加个 \ 把它降级成普通字符
8.3 用八进制和十六进制表示字符: \ddd 和 \xhh
除了 \n 这种"字母型"转义, 还可以直接用数字指定一个字符的编码.
\ddd 是八进制(ddd 是 1~3 位八进制数字):
1 | printf("%c\n", '\101'); // 八进制 101 = 十进制 65 = 'A' |
\xhh 是十六进制(hh 是十六进制数字):
1 | printf("%c\n", '\x41'); // 十六进制 41 = 十进制 65 = 'A' |
这两个正好和存储器与进制里学的进制转换对上了: \101 里的 101 是八进制, \x41 里的 41 是十六进制, 它们其实表示同一个字符 ‘A’
易错点:
\x后面没有位数限制, 会一直往后吃十六进制数字, 直到遇到不是十六进制数字的字符为止. 而且它不检查是否超出范围, 只留最后一个字节实测一下
"\x41B": 编译器会警告hex escape sequence out of range, 然后把它整个当成一个编码0x41B. 而0x41B= 1051, 超出 1 字节, 截断后只剩1051 & 0xFF= 27. 也就是说你本来想要"AB", 结果得到的是一个乱七八糟的控制字符(该段截断部分超纲)正确写法是把字符串拆开, 利用 C 语言会自动拼接相邻字符串的特性:
1 | printf("%s\n", "\x41" "B"); // 输出 AB |
相比之下
\ddd是安全的: 八进制最多只吃 3 位. 所以"\1012"会被正确理解成'A'和'2'两个字符, 不会出问题
还有个陷阱:
1 | printf("%d\n", '\xff'); // 输出 -1, 不是 255 |
因为 \xff 是 255, 而 char 在 VC 下是有符号的, 255 超出了 127 的上限, 就绕成了 -1. 这和 4.3 节那个 char c = 128 是同一个道理
8.4 \0
\0 是空字符(ASCII 值为 0), 也就是字符串的结束标志. 它不是"数字 0", 而是"什么都没有". 这个到数组篇会反复用到
顺带说一句,
\r是回车(回到行首),\b是退格. 这两个平时用得少, 但可能会在题目里出现. 具体效果是: 当输出’abcdefg\r’后再输出’h’, 屏幕上的a~g会变成h, \b效果类似, 只不过是逐字替换
9 类型转换
不同数据类型混在一起运算时, 编译器会自动"往大的方向"转:
1 | int a = 5; |
但要注意一个经典陷阱:
1 | int a = 5, b = 2; |
先看第二行: a / bb 里 a 被自动转成了 double, 所以按小数除法算, 得 2.5, 正确
问题出在第一行: a / b 里两个都是 int, 所以先按整数除法算, 5/2 得到 int 的 2(小数部分直接扔掉), 然后才交给 %f. 但 %f 要求跟一个 double, 于是 printf 把整数 2 的二进制硬当成浮点数来解释 —— 解出来是个毫不相干的 0.000000
这句话到底在说什么? 关键在于同一串二进制, 按 int 解释和按 float 解释, 结果是完全不同的两个数.
整数 2 在内存里是 32 位, 只有最低两位是 1:
1 | 00000000 00000000 00000000 00000010 |
如果按 int 解释, 这就是 2. 但如果按 float 解释, 那就坏了. 回忆第 13 节讲的 IEEE 754 格式, float 的三段是这样分的:
1 | 0 00000000 0000000000000000010 |
- 符号位是 0, 表示正数, 没问题
- 但阶码 8 位全是 0 —— 在 IEEE 754 里, 阶码全 0 表示"这个数极其小"(属于非规格化数)
- 尾数只有末尾一点点有值
所以这个数被解释出来大约是 %f 默认只显示 6 位小数, 这么小的数自然就显示成 0.000000 了
换句话说:
0.000000不是"算错了得 0", 而是"把整数的二进制当成浮点数读出来, 恰好是个极小值, 在 6 位小数下显示为 0". 它其实不是 0, 只是小到被 6 位小数吃掉了这里要小心一件事:
%f和%e要求的是 double(64 位), 而整数是 int(32 位), 两者长度都不一样. printf 会按 double 去读那块内存, 多读了一半的位, 所以解出来的具体数值和"按 32 位 float 解释"并不相同. 这个细节不用深究(属于编译器实现层面), 记住结论就行: 类型不匹配时结果是随机的垃圾值, 不报错但也毫无意义
这也印证了第 2 节那句话: 类型决定了怎么解释内存里的 0 和 1. 同一串二进制, 换个类型解释就是另一个数
所以这里其实有两个坑叠在一起: 整数除法丢小数, 以及格式符和实际类型不匹配. 想得到 2.5, 必须先把其中一个转成小数:
1 | (double)a / b // 或者 |
强制转换的写法是在前面加括号包住类型:
1 | (double)a // 把 a 转成 double |
(int)3.99等于 3, 这个点常考. 强制转换是截断不是四舍五入整数除法丢失小数也是新手最容易踩的坑之一, 而且它不报错, 只是默默算错
10 printf/scanf 格式符
到这儿四个基本类型和修饰符都认识了, 可以开始看完整的用法了.
10.1 最常用的几个
1 | int a = 42; |
%f 默认输出 6 位小数. 想控制位数就写 %.2f:
1 | printf("%.2f\n", d); // 3.14 |
%f 和 %lf 的区别是容易错的一个点:
1 | double d; |
输入 double 用 %lf, 输出用 %f. 这个不对称性来自 C 语言的历史原因, 记住就行
10.2 整数还能按八进制和十六进制输出
%o 输出八进制, %x 输出十六进制:
1 | printf("%d\n", 255); // 255 十进制 |
*加上 # 可以带上前缀:
1 | printf("%#o\n", 255); // 0377 |
10.3 浮点数的指数形式: %e
%e 把小数按科学计数法输出:
1 | printf("%e\n", 1234.5678); // 1.234568e+03 |
规则是: 默认 6 位小数, 指数部分的 e 后面至少两位数字. %E 只是把 e 换成大写
这个方法在数字特别大或特别小的时候很好用:
1 | printf("%e\n", 0.00012345); // 1.234500e-04 |
*10.4 域宽: 让输出对齐
%md 表示"至少占 m 个字符宽", 不够就在左边补空格:
1 | printf("[%5d]\n", 42); // [ 42] |
这个在输出表格时很有用:
1 | printf("%-5s%-5s\n", "姓名", "年龄"); |
域宽也能和精度一起用, 对小数就是"数字宽度.小数位数":
1 | printf("[%8.3f]\n", 3.14159); // [ 3.142] |
对字符串用 .n 表示"最多输出 n 个字符":
1 | printf("[%8.3s]\n", "hello"); // [ hel] |
10.5 那个很绕的 %i
%i 在输出时和 %d 完全一样:
1 | printf("%d %i\n", 42, 42); // 42 42 |
但在 scanf 输入时, %i 会自动识别进制! 这是个陷阱. 写段程序试试:
1 | int a, b; |
两次都输入 010, 结果是:
1 | 输入 010 (用 %d 读): -> %d 得到 10 |
同样的输入 010, %d 读出 10, %i 读出 8. 因为 %i 会看前缀: 有 0 就当八进制, 有 0x 就当十六进制
10.6 修饰符 l 和 L
l 用在整数前表示 long, 用在浮点前表示 double:
1 | long a = 123456789L; |
L(大写)表示 long double:
1 | long double ld = 3.14159265358979L; |
易混点: 小写
l和大写L不是一回事. 在整数里%ld是 long, 在浮点里%lf是 double,%Lf才是 long double. 注意别和%ld/%Lf弄混考试真正会考的就是
%d、%c、%f、%s、%lf(输入 double)、%ld、%o、%x这几个. 域宽和%e了解即可,%i知道有这回事就行
10.7 一次看懂: 格式符总览
| 格式符 | 对应类型 | 例子与输出 |
|---|---|---|
%d |
int |
printf("%d", 42) → 42 |
%ld |
long |
printf("%ld", 42L) → 42 |
%u |
unsigned int |
printf("%u", 42u) → 42 |
%f |
float/double(输出) |
printf("%f", 3.14) → 3.140000 |
%lf |
double(scanf 输入) |
scanf("%lf", &d) |
%e |
浮点(指数形式) | printf("%e", 1234.5) → 1.234500e+03 |
%c |
char |
printf("%c", 'A') → A |
%s |
字符串 | printf("%s", "hi") → hi |
%o |
八进制输出 | printf("%o", 255) → 377 |
%x |
十六进制输出 | printf("%x", 255) → ff |
%i |
输入时自动识别进制 | 见 10.5 |
%% |
输出一个 % 符号 |
printf("100%%") → 100% |
11 单字符 IO: putchar 与 getchar
除了 printf/scanf, 还有两个专门处理单个字符的函数:
1 | char c = getchar(); // 从键盘读一个字符 |
它们比 printf/scanf 更轻量, 而且不需要格式符. 注意两个细节:
getchar 的返回值是 int 而不是 char. 这是为了能表示一个特殊值 EOF(值为 -1), 表示"读到文件末尾了". 平时用 char 接也能跑, 但严格来说是错的
getchar 会把回车也读进去. 这是个经典陷阱, 也是getchar的一个极强的功能:
1 | char a, b; |
因为回车键本身也是一个字符('\n', ASCII 为 10), 它会留在输入缓冲区里等着被读. 想读下一个有效字符得先把回车"吃掉"
getchar和putchar的经典用法是配合循环逐字符处理:
1 | int c; |
这段代码的意思是"一直读字符并原样输出, 直到读不动为止"(在 Windows 下按
Ctrl+Z回车表示 EOF). 这里c声明成int就是为了接住那个-1
12 一个完整的例子
把这篇的东西串起来:
用 getchar 读入一个字符, 用 scanf 读入一个整数
输出该字符、它的 ASCII 码、它的下一个字符
输出字符 ASCII 码与整数的和, 以及这个和除以 2 的平均值(保留两位小数)
示例输入输出见下
示例代码
1 |
|
运行一下(输入 A 再输入 10):
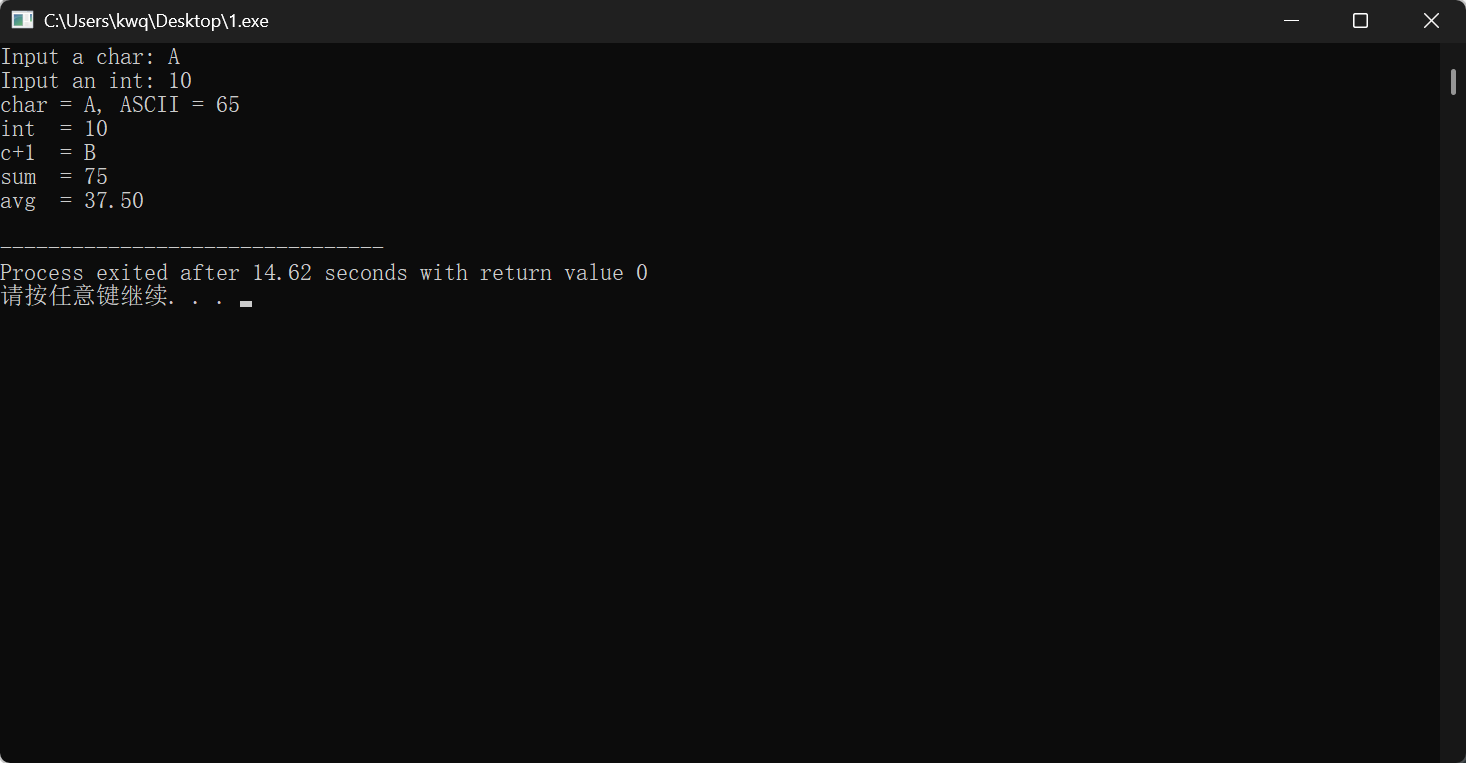
这一小段程序其实用到了本篇几乎所有东西:
char和int两种类型(第 4 节)- ASCII 码参与运算,
c + 1得到B(第 4.2 节) getchar吃回车的坑(第 11 节)%c和%d的区别: 同一个c输出成两种样子(第 10 节)- 强制类型转换
(double)(第 9 节) - 整数除法的坑: 不加强转的话
avg会变成0.000000 - 保留两位小数: printf的格式符
最后一行如果写成
(c + n) / 2, 结果不是 37.5, 也不是 37.0, 而是0.000000因为
(c + n) / 2是整数除法, 算出的是 int 类型的 37. 而%f要求后面必须跟一个 double, 于是 printf 硬把整数 37 的二进制当成浮点数来解释, 解出来就是个完全不相干的数
*13 拓展: 数据在内存中的存储形式
前面一直说"类型决定了怎么解释 0 和 1", 这一节就把这句话落实.
13.1 整型: 补码
整数在内存里用补码存. 正数的补码就是它自己; 负数的补码是"取反加一".
拿 int 4 字节来看 5 和 -5 的实际二进制:
1 | 5 -> 00000000 00000000 00000000 00000101 |
-5 是怎么来的? 把 5 的每一位取反, 再加 1:
1 | 5 = 00000000 00000000 00000000 00000101 |
为什么不用"最高位当符号位"的简单办法? 因为补码让减法可以当加法算, CPU 只需要一套加法电路就够了. 而且 0 只有一种表示(原码会出现 +0 和 -0 两种)
这也解释了为什么
int的范围是到 , 即 -2147483648 到 2147483647. 负数那边能多表示一个, 就是因为 0 只占一种编码 也解释了溢出:
INT_MAX + 1得到的是 -2147483648, 因为二进制加一之后正好翻到了补码的负数那一端
13.2 实型: IEEE 754
小数在内存里不是简单的"整数部分+小数部分", 而是按 IEEE 754 标准拆成三段.
float 占 4 字节 32 位, 分成:
1 | 1 位 8 位 23 位 |
- 符号位 S: 0 为正, 1 为负
- 阶码 E: 存的是"指数 + 127"(叫偏移量)
- 尾数 M: 存的是小数点后面的部分
拿 12.5 走一遍. 先把它转成二进制:
规格化成 $1.xxx \times 2^n$ 的形式(小数点移到第一个 1 后面):
现在取三个部分:
- 符号位: 正数, 所以是 0
- 指数是 3, 加偏移 127 得 130, 转二进制是 10000010
- 尾数是小数点后的
1001, 右边补 0 凑够 23 位
拼起来就是:
1 | 0 10000010 10010000000000000000000 |
按 8 位分组:
1 | 01000001 01001000 00000000 00000000 |
这和实际打印出来的内存完全一致. 再看 1.0:
- 符号 0
- 指数 0 + 127 = 127 = 01111111
- 尾数全 0
1 | 0 01111111 00000000000000000000000 |
double 是同样的道理, 只是位数更多: 1 位符号 + 11 位阶码 + 52 位尾数, 共 64 位, 偏移量是 1023
但位数再多也是有限的, 所以浮点数一定会丢精度.
float的尾数只有 23 位, 很多小数(比如0.1)根本存不准; 而且数值越大, 能表示的间隔越宽, 精度越差. 这两点合起来就是浮点数的"精度丢失", 下面 13.3 节会展开讲
尾数不用存 1 的原因: 规格化之后, 小数点前面永远是 1, 那就没必要浪费一位去存它, 直接省略. 这叫"隐含的 1", 相当于白赚了一位精度
浮点数按 符号、阶码、尾数 三段存;
float是 1+8+23,double是 1+11+52; 阶码存的是加过偏移量的值, 不是指数本身
13.3 由此理解精度问题
既然尾数只有 23 位, 能表示的组合数就是有限的, 所以很多小数根本存不准. 比如 0.1:
1 | float a = 0.1f; |
存进去再拿出来, 已经不是精确的 0.1 了. 这就是为什么判断两个浮点数是否相等不能用 ==, 而要看差值是否小于一个很小的数
float 大约能保证 6 位有效数字, double 大约 15 位. 这也是前面建议"平时直接用 double"的原因
为什么会有精度丢失
回到 IEEE 754 的格式. float 的尾数只有 23 位, 加上隐含的那个 1, 有效数字也就 24 位. 24 位二进制大概对应16777216, 有 8 位十进制, 但它是个临界值: 到它为止, 每个整数都还能被精确表示; 再往上就做不到了.
原因是尾数位数固定, 而阶码决定了小数点的位置. 当数值变大时, 小数点要往右移, 留给小数部分的位数就变少了. 具体来说:
- 阶码为
时, 相邻两个能表示的浮点数之间的间隔是 - 数值越大,
越大, 这个间隔就越大
所以浮点数在数轴上不是均匀分布的: 靠近 0 的地方排得很密, 越往两边越稀疏. 这就是精度丢失的根本原因
例题: 2^24 加 1
问: 下面这段代码输出什么?
1 | float a = 16777216.0f; // 就是 2^24 |
答案是:
1 | 16777216 |
加 1 完全没效果 是因为
对比 double, 它尾数有 52 位, 精度高得多:
1 | double d = 16777216.0; |
这道题如果出现, 选项一般会很贴心地给出
16777216和16777217让你选. 记住结论:float能精确表示连续整数的上限是, 超过这个数就开始丢精度
关联: Minecraft 的"远东现象"
这个原理在 Minecraft 里有个很有名的体现
MC 世界里, 玩家的坐标是用 float 存的. 正常情况下坐标很小, 精度够用. 但如果用指令把自己传送到很远的地方(比如坐标几十万、几百万), 就会出各种怪事: 玩家会不停抖动、走路卡顿、方块渲染错乱、甚至掉出世界. 玩家管这叫**“远东现象”**
原因就是上面那个公式. MC 世界的边界在
在 3000 万坐标处, 相邻两个能表示的位置相差 2. 意味着:
1 | float x = 30000000.0f; |
连 “+1” 都挪不动了. 游戏里一切位置判断都建立在这个数值上, 而游戏内很多逻辑要求精确到 1 格, 精度不够自然就乱套了
这也解释了两件事: 为什么 MC 的世界边界定在 3000 万左右——再往外 float 已经彻底不可用了; 为什么这个现象在远离原点时才出现——因为靠近原点时间隔还很小(
附近的间隔只有约 ), 完全够用 后来有 mod 用 double 存储坐标来绕过这个问题——毕竟
double有 52 位尾数, 能精确表示的范围大得多
13.4 溢出会怎样
不同类型溢出的表现完全不同, 这是道挺有意思的题.
整数溢出会"回绕":
1 | int a = 2147483647; // INT_MAX |
因为补码加一正好翻到负数那一端, 不会报错, 只是结果莫名其妙
浮点数溢出会变成 inf:
1 | float f = 3.4e38f; // float 的最大值附近 |
inf 是 infinity(无穷大)的缩写, 会直接打印出来. 这也是为什么浮点比整数"安全"一点——至少它不会悄悄给你一个毫不相干的小数字
同样道理, 浮点数还有一个
nan(Not a Number), 出现在0.0/0.0这种非法运算里记住对比——整数溢出回绕成另一个数(不报错), 浮点溢出变成
inf
13.5 char 的存储
char 最简单, 就 1 字节, 存的是字符的 ASCII 码:
1 | 'A' -> 01000001 (十进制 65) |
所以 char 在内存里和一个小整数没有任何区别, 这正好呼应了 4.2 节说的"字符本质是数字"