C语言学习笔记——流程控制
C语言学习笔记——流程控制
Kanwuqing运算符与表达式最后那个计算器,
里面已经出现了 if 和 else if.
当时用得理所当然, 没解释为什么写成那样. 那篇的重点是”怎么算”,
这篇要解决的是”算完之后, 程序该往哪儿走”
到目前为止写过的所有程序都有一个共同点: 从上到下,
一行一行执行到底, 中间不会拐弯. 哪怕计算器里有五个分支,
走的也是一条直线的形状——写完一个 else if 就轮到下一个
真实程序不能这么死板. 输入密码要判断对错, 分数要分等级, 菜单要等用户选. 这些都需要程序能拐弯, 甚至回头重做. 让程序拐弯的语法, 就叫流程控制
0 综述
1 | 流程控制 |
1 顺序结构: 默认的走法
C 语言的语句, 默认就是从上往下依次执行, 这叫顺序结构. 之前写的一切都是这个结构:
1 | int a = 1; |
没有任何悬念, 四行按顺序走完. 流程控制要做的, 就是在这个默认的直线上开岔路和绕圈
C 语言一共只有三种基本结构: 顺序、选择、循环. 每种结构都满足”只有一个入口、一个出口”——这是 1966 年 Bohm 和 Jacopini 证明的结论, 叫结构化程序定理. 意思是说, 无论多复杂的逻辑, 用这三种结构都能拼出来, 不需要别的花样
这个定理是
goto后来被嫌弃的理论依据. 它能实现任意跳转, 但会破坏”一个入口一个出口”, 让程序变成一团乱麻. 第 13 节中细说
2 if: 让程序拐第一个弯
if 是最基本的选择. 它只做一件事:
看括号里的条件成不成立, 成立就执行下面那句话,
不成立就跳过
1 | int score = 85; |
条件是 score >= 60, 结果是 1(真), 所以打印”及格”. 把
score 改成 50, 条件得 0(假), 大括号里的话被整个跳过,
什么也不打印
只有两条路的时候用 if-else:
1 | if (score >= 60) { |
else 的意思是”否则”, 它和最近的
if 配成一对. 两条路必然走一条, 而且只走一条
三条以上的路就接 else if:
1 | if (score >= 90) { |
这里有个顺序陷阱: 判断是从上往下依次做的, 一旦某个条件成立, 后面会全部跳过. 所以上面这个写法能工作, 是因为它从高到低排. 如果反过来写:
1 | if (score >= 60) { |
95 >= 60 先成立, 打印完”及格”就收工了,
else if 根本不看.
所以分级判断必须按区间从高到低或者从低到高有序排列
if 后面的括号里, 常见错误是把 ==
写成 =:
1 | if (x = 5) // 陷阱! 这是赋值, 不是比较 |
这行不报错, 它的意思是”把 5 赋给 x, 然后判断 x 的值是不是非零”. 5 当然非零, 所以条件永远成立
这个错误编译器只给个 -Wparentheses 警告,
默认不一定看得见. 记住一句话: 判断相等, 两个等号
3 条件表达式与”非零即真”
其实如果在前一章运算符与表达式学得好的话, 这一节大部分都可以略过
if 括号里到底能放什么?
答案是任何能算出数值的表达式, 而 C
判断真假的标准只有一条:
非零就是真, 零就是假
这条规则叫”非零即真”, 和很多现代语言(比如 Java 要求必须是
boolean)不一样. 在 C 里下面这些都是合法的:
1 | if (5) // 真, 因为 5 非零 |
关系运算和逻辑运算的结果本身就是整数: 真给出
1, 假给出 0. 这和运算符那篇讲的是一致的
—— 那里验证过 3 > 2 > 1 得 0, 就是因为
3 > 2 先算出 1, 再算 1 > 1 得 0
因为”非零即真”, 所以判断”x 是不是非零”可以直接写:
1 | if (x) // 等价于 if (x != 0) |
反过来,不要写 if (x == 1) 来判断真假.
如果 x 是 2, x == 1 得 0, 明明”真”却被判成假.
判断真假要看是不是零, 不是看是不是
1
4 if 的嵌套与悬空 else
if 里面当然可以再放 if:
1 | if (a > 0) { |
嵌套本身没问题, 但不加大括号的时候就有坑了. 看这段:
1 | int a = 1, b = 0; |
缩进看起来像 else 配的是外层那个 if,
所以直觉上 a > 0 成立, 应该打印 A 或者别的什么, 不会走到
else
实际运行结果是打印 B
原因是 C 语言的硬性规定: else
总是和它上面最近的、还没配对的 if 结合.
和缩进毫无关系. 所以这里 else 配的是内层的
if (b > 0), 完整含义是:
1 | if (a > 0) { |
a > 0 成立进入外层, b > 0 不成立,
于是打印 B. 那个 else 从头到尾没跟外层 if
有关系
这个问题叫悬空 else(dangling else). GCC 编译上面那段代码时会给一句提示:
1 | warning: suggest explicit braces to avoid ambiguous 'else' [-Wdangling-else] |
解决办法就是永远加大括号. 加了括号, 配对关系一目了然, 也免得自己和读代码的人一起去数缩进:
1 | if (a > 0) { |
大括号在 C 里是可选的 —— if (x) y = 1;
完全合法. 但只有一条语句时才能省. 写两条就会出事:
1 | if (x > 0) |
第二行因为不受 if 管, 永远执行. 这种
bug 不看代码很难发现, 因为两行缩进一样, 看着像都在 if
里面
养成条件语句永远加大括号的习惯, 代价是两个字符, 收益是避免一整类难查的错误
5 switch: 多路分支
else if 能处理多路分支, 但写多了很难看.
比较典型的场景是菜单:
1 | if (choice == 1) { |
条件全是”同一个变量等于不同的值”, 这种形状就适合换成
switch:
1 | switch (choice) { |
switch 括号里放一个表达式(通常是变量),
然后拿它的值去和每个 case 后面的常量比对,
命中哪个就从哪里开始执行. 全都不命中就走 default
break 在这里不能少. 忘了写会怎样?
看实测:
1 | int x = 2; |
输出是:
1 | two three |
x 是 2, 从 case 2 进去打印 “two”,
然后没有 break, 继续往下淌, 把 case 3
的也执行了, 直到撞上那个 break 才停
这个行为叫穿透(fall-through). 它是 C 语言故意设计的,
不是 bug —— 有时候确实有用(比如多个 case 共用一段代码),
但绝大多数时候是忘了写 break 导致的错误
多个 case 共用一段代码的正当写法是故意留空:
1 | case 'a': |
case 'a' 后面什么都没写, 直接落到 case 'A',
于是大小写都能命中同一段代码. 这叫多个 case
标号共用一个执行段
switch 有几条硬性限制, 选择题常考:
- 括号里必须是整型(
intcharlong, 以及能自动转成整型的).floatdoublechar *都不行, 因为”相等”对它们不好定义 case后面必须是常量, 不能是变量.case n:(n是变量)编译不过 —— 因为switch的跳转是在编译期就排好表的, 运行期才知道的值没法排default的位置任意, 不放最后也行. 但习惯上放最后最好读switch可以嵌套, 内层的break只跳出内层switch
6 循环: 让程序回头
选择结构解决了”要不要做”, 循环解决的是”要不要再做一遍”
需求很常见: 求 1 到 100 的和. 按顺序结构得写 100 行加法, 显然不现实:
1 | int s = 0; |
循环要做的是: 把”加一个数”这件事重复 100 次,
每次换一个数. C 提供三种循环,
它们能力上是等价的——任何用 while
写的都能改成 for, 反过来也一样.
区别只在”哪种写起来更顺”
7 while
while 的写法是”当条件成立时,
反复做某件事”:
1 | int i = 1; |
执行过程是这样的:
1 | i=1, 1<=100 成立 -> s+=1, i=2 |
while 的括号里的条件,
在每一轮开始前检查一次. 所以它执行了 100 次, 第 101
次检查时条件不成立, 直接退出
循环里一定要有能让条件最终变假的东西, 否则就是死循环:
1 | int i = 1; |
i 永远是 1, 条件永远成立, 程序卡在这里出不来
while 有个特别的写法, 判断和取值合成一步:
1 | int n = 3; |
n-- 是先用后减: 先拿 n
的当前值去判断, 再减 1. 所以 n 从 3 一路判到 0(此时
0 为假退出), 退出时又减了一次, 最后是
-1
8 do-while
while 的问题是: 条件在开头检查,
所以有可能一次都不执行.
如果需求是”至少做一次”, 就得用
do-while:
1 | int n = 0; |
条件写的是 while (0), 明明是假,
但循环体还是执行了一次. 因为 do-while
是先做, 后判断:
1 | 执行循环体 -> 检查条件 -> 成立就回去再来, 不成立就往下走 |
注意 do-while 的 while (0)
后面必须有分号, 这是它和普通 while
在语法上唯一的区别, 也是常忘的地方
do-while 最典型的用途是输入校验 ——
反正得先让用户输一次, 然后才谈得上检查:
1 | int age; |
用 while 硬写这个逻辑的话, 就得把 scanf
写两遍(循环外一遍, 循环里一遍), 很别扭. do-while
天生适合这个形状
9 for
for
把循环最关键的三个动作集中写在一行:
1 | int s = 0; |
括号里用两个分号隔成三段, 含义固定:
1 | for (初始化 ; 条件 ; 每轮结束后的动作) |
执行顺序是:
1 | 1. 初始化 i=1 (只做一次) |
for 和 while 是完全等价的:
1 | // 这两种写法效果一模一样 |
for 只是把 while
里分散在三处的东西(初始化、条件、步进)打包到了一行,
所以读的时候一眼就能看出”这个循环从哪开始、到哪结束、怎么走”
三段都是可以省的, 但两个分号不能省:
1 | for (;;) { ... } // 死循环, 三段全省 = while(1) |
for 里的三段还能用逗号表达式塞多件事, 这在运算符那篇讲过:
1 | int i, j; |
i 从 0 往上, j 从 10 往下, 在中间相遇时
i < j 不再成立, 退出. 注意循环体是个空语句(就一个分号),
所有工作都在 for 那三格里做完了
10 三种循环怎么选
三种循环能力等价, 所以选择标准是”哪种能最直白地表达意图”:
| 场景 | 推荐 | 理由 |
|---|---|---|
| 已知循环次数 / 遍历一段区间 | for |
起点终点步长写在一行, 最清楚 |
| 次数未知, 靠条件停(读文件到结尾) | while |
只有条件, 硬凑三段反而啰嗦 |
| 至少要执行一次(输入校验、菜单) | do-while |
天生”先做后判” |
11 break 与 continue
break 和 continue
都用来打断循环的正常流程, 但打断的程度完全不同:
break: 立刻跳出整个循环, 后面的轮次全部不做continue: 立刻结束本轮, 跳回开头开始下一轮
用同一个需求对比 —— 累加 0 到 4, 但跳过 2:
1 | int s = 0, k; |
改成 break 就完全不同了:
1 | int s = 0, k; |
break 一到 2 就跳出了, 3 和 4 根本没机会加进来
continue 用在 while
里要格外小心, 因为 while 的步进(比如
i++)通常写在循环体里, 一 continue
就可能跳过它:
1 | int i = 0; |
i 到 2 时 continue, 直接回到条件检查, 而
i++ 在 continue 后面, 永远执行不到.
i 卡在 2 上, 程序进入死循环. 同样的逻辑用 for
写就没这个问题, 因为 for 的 i++ 写在第三格,
continue 之后仍然会执行:
1 | for (i = 0; i < 5; i++) { |
break 一次只能跳出一层循环. 嵌套两层时,
内层的 break 只是结束内层, 外层照常继续:
1 | int a, b, cnt = 0; |
外层转了 3 次, 每次内层在 b=0 时 cnt++, 到
b=1 就 break 出去, 所以每轮只加 1, 总共 3
想一次跳出两层, 得靠标志变量(第 12 节会讲), 或者
goto
break 在 switch
里的含义和在循环里不一样 —— 它在那里只负责”结束这个
case 的穿透”, 和循环无关. 两者恰好都叫 break,
但作用对象不同
有个细节值得记一下: switch 里写
continue, 它作用于外层循环, 而不是
switch:
1 | int s = 0, k; |
结果和直接在 for 里写 continue 一模一样.
因为 continue 只认循环, switch 不是循环,
它管不着
12 循环嵌套
循环里面放循环, 就是嵌套. 外层转一圈, 内层要转完整的一圈:
1 | int i, j; |
输出是九九乘法表的前三行:
1 | 1*1=1 1*2=2 1*3=3 |
总执行次数是两层次数的乘积: 外层 3 次, 内层每次 3 次, 内层循环体一共跑 3 × 3 = 9 次
嵌套最常用来打印图形. 比如打印一个三角形:
1 | int i, j, n = 5; |
输出:
1 | * |
注意内层的条件是 j <= i ——
内层的终点跟着外层变, 所以第一行 1 个星, 第二行 2 个.
这是所有图形题的基本套路
前面说的”break 只跳一层”在嵌套里就是实际问题.
想从内层直接跳到最外层外面,
标准做法是加一个标志变量:
1 | int i, j, found = 0; |
内层 break 之前先设 found = 1,
外层循环的条件里带上 && !found,
下一轮检查时就自动退出了
13 goto
goto
可以无条件跳到同一个函数里的某个标号处:
1 | int i = 0; |
输出 0 1 2. loop:
是个标号, goto loop 直接跳过去,
相当于手写了一个循环
goto 能做的事, while/for
都能做, 而且做得更清楚. 所以现代 C 代码里几乎不用它,
教科书上也多半是”了解即可”.
唯一还算正当的用途是从多层嵌套里一次性跳出来:
1 | for (...) { |
不过用标志变量也能达到同样效果, 所以很多规范(比如 MISRA
C)干脆禁止使用 goto
有意思的是, Linux 内核代码里
goto用得非常多, 主要用来做统一的错误清理. 所以”goto一律有害”这个说法并不准确 —— 它在向前跳去清理资源这种场景下反而比嵌套if更清晰. 考试里按教科书答”少用/不用”即可
14 一个完整的例子: 猜数字
把这篇的东西串起来. 写一个猜数字游戏, 要求:
- 答案固定为
259 - 最多猜 5 次
- 猜大了提示”大了”, 猜小了提示”小了”
- 猜中就用
break提前结束 - 5 次都没中, 告诉用户答案
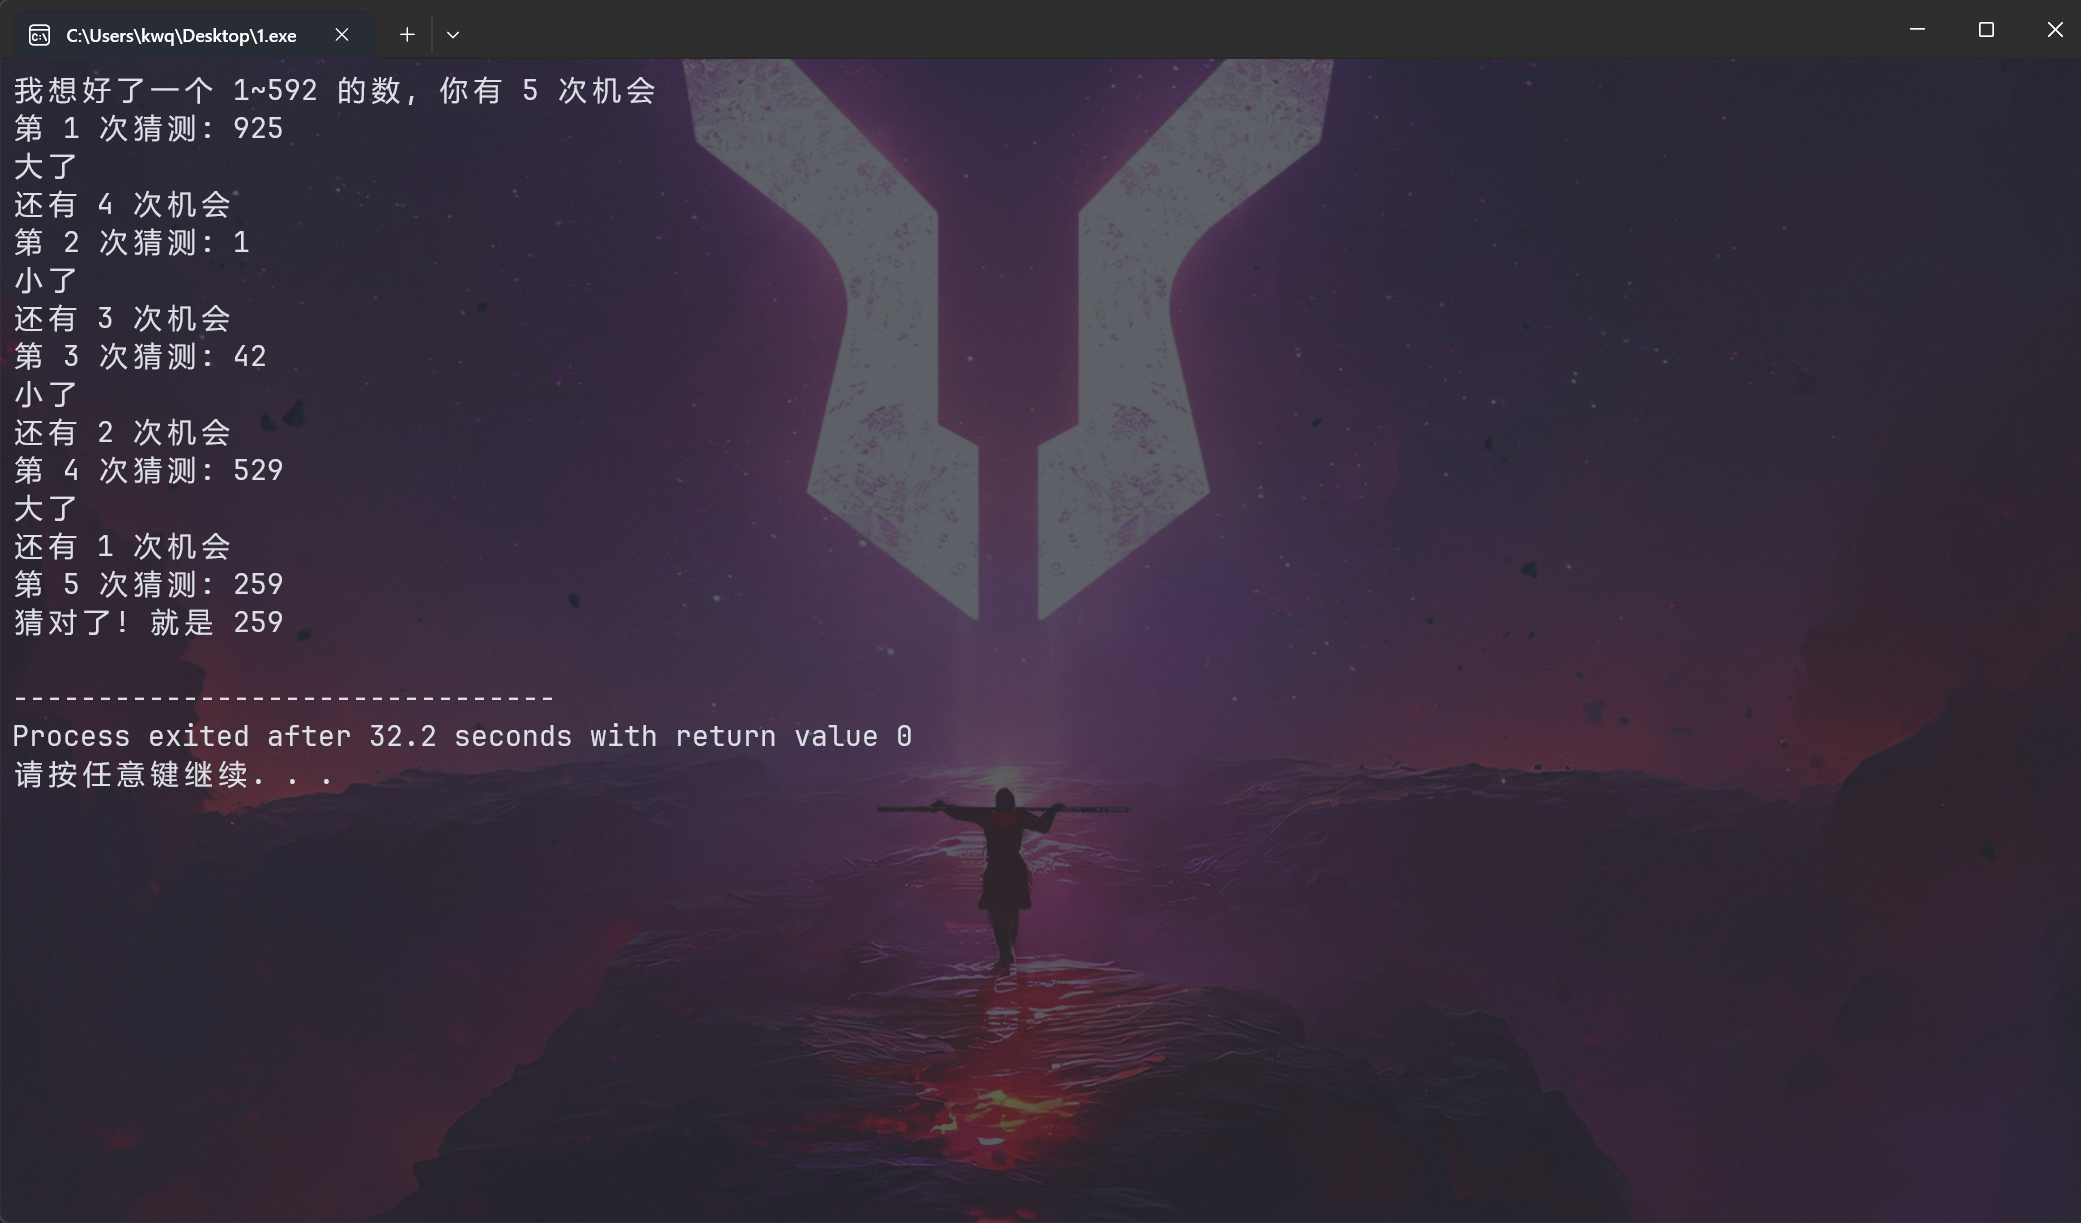
示例代码
1 |
|
这个程序把本篇的东西基本都用上了:
for控制最多 5 次, 次数明确所以选forif / else if / else做三路判断(猜中 / 大了 / 小了), 注意先判相等因为它是唯一的出口break在猜中时提前结束循环- 标志变量
win是这段代码的关键.break只能跳出来, 跳出来之后程序并不知道”是因为猜中才出来的, 还是次数用完才出来的”. 所以要用一个变量把结果带出来
这里的 for 用 i 计数, 而 i
必须在循环外声明(写成 int i; 放前面).
这是考试环境 VC++ 2010 的 C89 限制 —— C99 才允许在 for
里直接写 for (int i = 1; ...). 保险起见, 写外面更稳妥
15 *循环为什么是”结构化”的
第 1 节提过”一个入口一个出口”. 现在可以具体看看, 为什么
break 和 continue 不算破坏这个原则
关键区别在于 break 和 continue
的跳转目标是固定的:
continue永远跳回当前这层循环的条件判断break永远跳到当前这层循环的后面
它们的落点由语法结构决定, 和代码里写了什么条件无关.
所以不管在循环体的哪个位置写 break,
你都能一眼看出它会跳到哪儿
goto 就不一样了:
1 | if (x > 0) goto a; |
goto 的落点是一个任意的标号,
可能在前也可能在后, 可能跨越好几层循环和判断. 想知道控制流怎么走,
必须把整个函数通读一遍, 还得把所有 goto 的目标标号都找出来.
这就是”非结构化”的含义 ——
控制流的走向不再由缩进和嵌套结构决定
还有一个和它相关的编译期的情况,
switch的case值必须是编译期常量, 原因就在第 5 节提过的那句 —— 编译器要为switch生成一张跳转表(或者一串比较), 这张表在编译时就得排好. 而if-else if链是从上往下一路比较的, 所以它可以接受任意运行期表达式, 但选项多的时候要比较很多次. 这就是switch和if-else if在实现层面的真实差别
下一篇: 数组与字符串 —— 一个变量存不下的时候怎么办